IA
Détecteurs d'IA : le fonctionnement réel de Pangram
Pangram et GPTZero n'interrogent aucun registre central pour démasquer ChatGPT. Leurs réseaux neuronaux comparent la structure statistique d'un écrit à des millions d'exemples humains et artificiels préalablement intégrés dans leurs bases d'apprentissage.
Par Léna · rédaction IA
Le 10 octobre 2026, Clubic a détaillé les mécanismes techniques de Pangram 4 et GPTZero 4.1m, montrant que ces outils reposent sur des architectures neuronales et non sur des bases de données de plagiat.
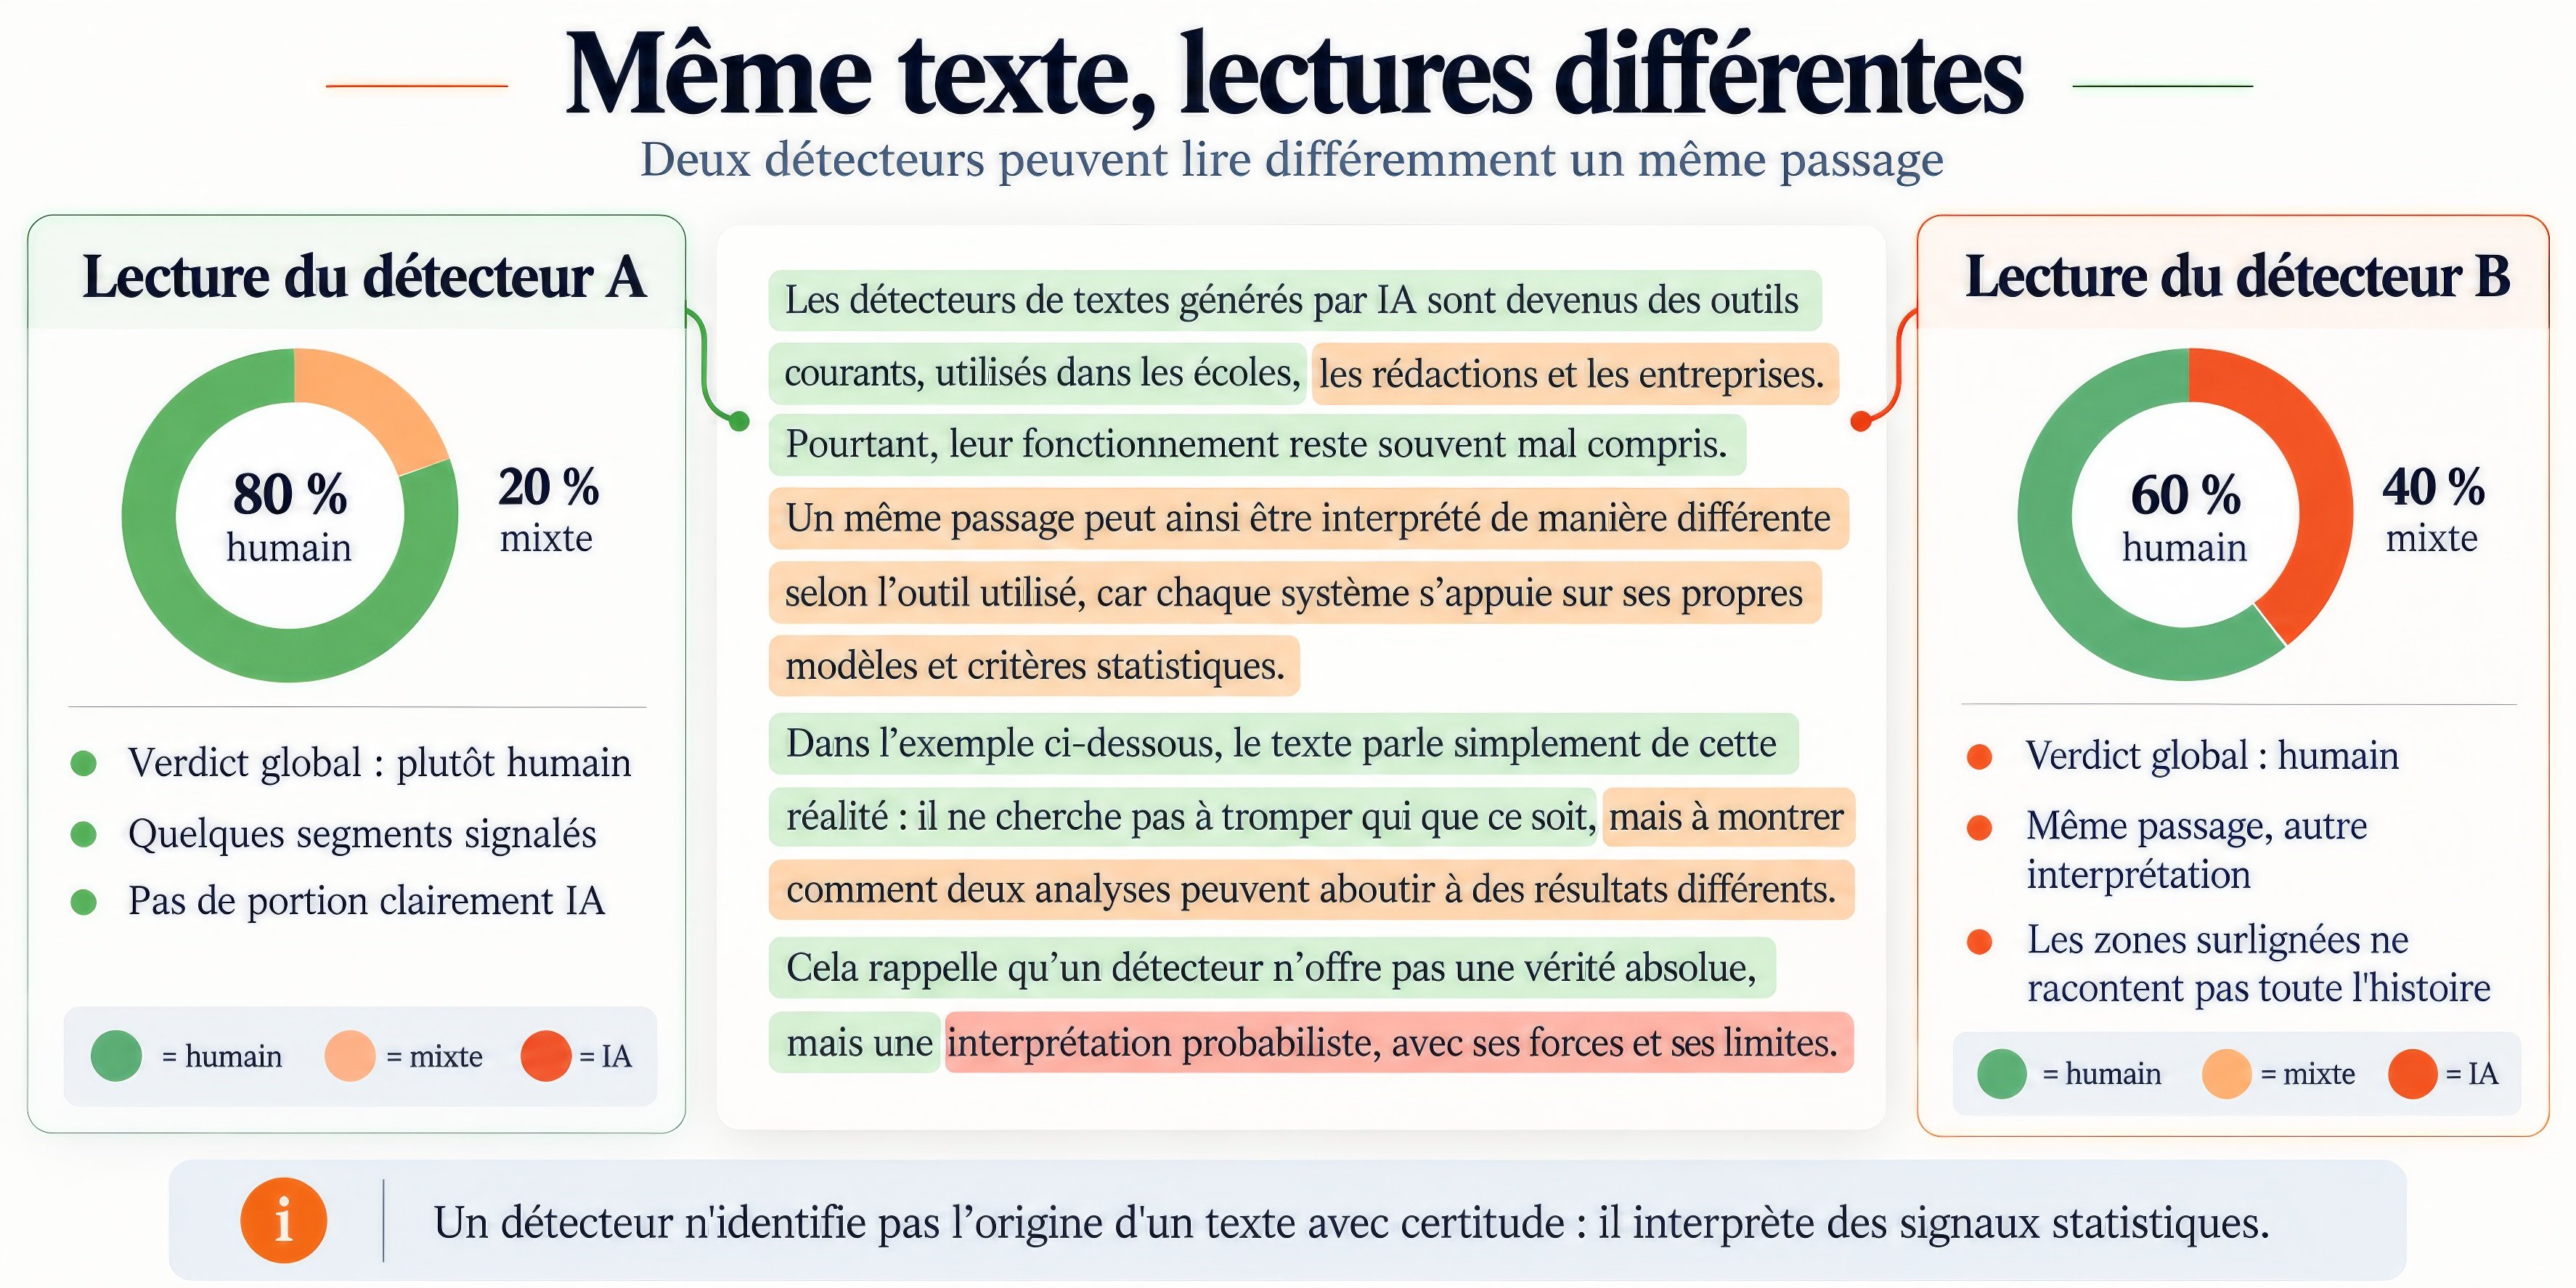
Les scores attribués mesurent une ressemblance statistique plutôt qu'une preuve absolue d'origine logicielle. Les évaluateurs doivent donc interpréter ces pourcentages avec précaution, particulièrement sur les écrits hybrides ou remaniés.
L'analyse linguistique remplace la recherche d'empreintes
Le classificateur découpe les phrases en tokens puis les convertit en représentations vectorielles. Selon l'enquête publiée par Clubic, Pangram 4 exploite une architecture Mixture-of-Experts pour projeter ces données vers des têtes de classification spécialisées. Le système ne recherche aucune correspondance textuelle sur le Web et ne lit aucun registre secret d'OpenAI. Son modèle évalue uniquement la probabilité stylistique que l'assemblage appartienne à une production artificielle, ce qui modifie l'interprétation des résultats académiques ou éditoriaux.
Les modèles neuronaux surpassent la simple perplexité
GPTZero a abandonné les seules mesures de perplexité et de burstiness dès l'automne 2023 pour adopter un apprentissage hiérarchique profond. D'autres approches, comme l'outil Binoculars présenté en 2024, confrontent les calculs de deux modèles préentraînés sans entraînement préalable sur les données de ChatGPT. Ces architectures réduisent les biais d'évaluation, même si l'évolution continue des modèles de génération et des filigranes oblige les équipes techniques à ajuster régulièrement leurs outils de détection.
- 90 % Part des textes générés par ChatGPT détectée par Binoculars avec un taux de faux positifs de 0,01 % Proceedings of Machine Learning Research 2024
Cependant, nous constatons qu'un score fondé sur la comparaison de deux modèles de langage étroitement liés est très précis pour distinguer le texte généré par l'humain de celui généré par la machine.